Il metodo di Anthropic per capire se un’intelligenza artificiale migliora davvero
Un’azienda mette in produzione un agente IA per il servizio clienti. Dopo due settimane qualcuno nota che le risposte sono meno precise di quanto sembrassero durant…
I test e benchmark AI (MMLU, GPQA, SWE-bench, HumanEval, MT-Bench, Chatbot Arena) misurano le capacita dei modelli su compiti specifici. Servono a decidere quale modello adottare, ma sono spesso mal interpretati. Aggiornamenti classifica, spiegazioni metodologiche, critiche (data contamination, overfitting sui benchmark), test comparativi indipendenti in italiano su casi reali.
Un’azienda mette in produzione un agente IA per il servizio clienti. Dopo due settimane qualcuno nota che le risposte sono meno precise di quanto sembrassero durant…
notizie
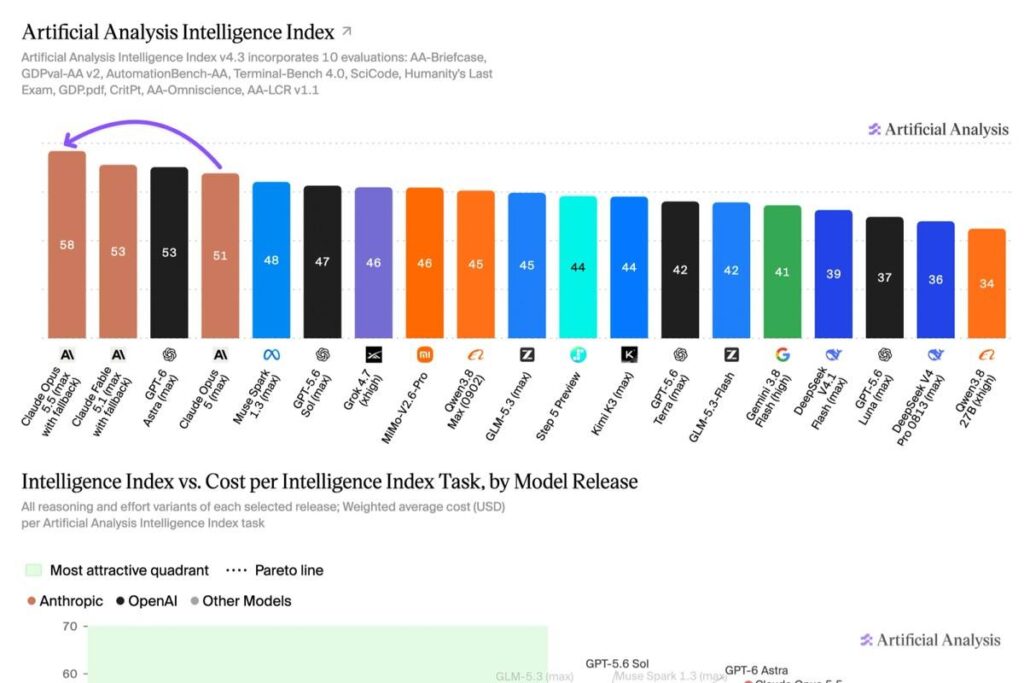
A poche ore dal lancio di Claude Sonnet 5.5, arriva anche il primo verdetto indipendente sul mo…
29 Settembre 2026 · 3 min
notizie
Due messaggi cifrati con la macchina Enigma, rimasti indecifrabili per decenni nonostante gli s…
26 Settembre 2026 · 3 min
confronti
Il 22 settembre OpenAI e Anthropic hanno aggiornato a poche ore di distanza i rispettivi modell…
25 Settembre 2026 · 8 min
notizie
Artificial Analysis, uno dei gruppi indipendenti più seguiti per la valutazione dei modelli di…
23 Settembre 2026 · 3 min
notizie
Le misure indipendenti di Artificial Analysis: stesso punteggio del rivale al 40% del costo per…
19 Settembre 2026 · 3 min
notizie
ARC Prize ha finito di verificare GPT-6 Astra sul proprio test ARC-AGI-3 e ha pubblicato due nu…
19 Settembre 2026 · 3 min
recensioni
Due mesi dopo il lancio, Claude Opus 5 alla prova: quanto costa davvero, cosa dicono i benchmar…
17 Settembre 2026 · 9 min
notizie
Dieci compiti presi da software aziendali veri, 640 esecuzioni: il modello migliore ne risolve…
13 Settembre 2026 · 4 min
notizie
Artificial Analysis: GPT-6 Astra pareggia Claude Fable 5.1 consumando un terzo dei token, ma su…
13 Settembre 2026 · 3 min