Chi costruisce qualcosa sopra un modello linguistico si accorge presto di una cosa: la bolletta non la fa la qualità delle risposte, la fa il volume. Un’app che classifica trecento email al giorno chiama il modello trecento volte al giorno, e ogni chiamata si paga a token. Se per quel lavoro usi il modello più grosso sul mercato, stai pagando cinque o dieci volte tanto per un compito che un modello piccolo svolge identico.
Qui parliamo delle due famiglie “piccole” più usate: Claude Haiku di Anthropic e Gemini Flash di Google. Vediamo quanto costano davvero in euro, dove reggono e dove no, e facciamo il conto di un’applicazione reale invece di limitarci a mettere due tabelle una accanto all’altra.
Una precisazione sul vocabolario, perché ci serve per tutto il resto. Il token è l’unità con cui i modelli misurano il testo: circa quattro caratteri, quindi una parola italiana media vale uno o due token. I prezzi si esprimono per milione di token, distinguendo tra input (quello che mandi al modello: istruzioni, documento, domanda) e output (quello che il modello scrive). L’output costa sempre molto più dell’input, di solito cinque volte tanto.
Cosa vuol dire davvero “modello piccolo”
“Piccolo” non è una misura ufficiale, e nessuno dei due fornitori dichiara quanti parametri abbiano questi modelli. È una collocazione commerciale: sono i modelli che l’azienda posiziona sotto ai propri modelli di punta, con prezzi più bassi e risposte più veloci.
La cosa interessante è che il confine si sposta in fretta. Quando Anthropic ha presentato Haiku 4.5, nell’ottobre 2025, l’annuncio ufficiale diceva che il modello raggiunge prestazioni di codifica simili a Claude Sonnet 4 — cioè al modello di fascia media di cinque mesi prima — a un terzo del costo e a più del doppio della velocità. Sulla stessa pagina Anthropic dichiara 73,3% su SWE-bench Verified, un test su problemi di programmazione reali presi da repository open source, con una metodologia descritta in fondo all’annuncio (media su 50 tentativi, budget di ragionamento da 128k token). È un numero pubblicato dal fornitore, non un test indipendente: prendilo per quello che è.
Il punto pratico è che il modello piccolo di oggi fa il lavoro che dodici mesi fa richiedeva il modello grande. Se hai scelto il tuo modello nel 2024 e non hai più rivisto la scelta, molto probabilmente stai pagando troppo.
I prezzi, in euro
I listini ufficiali sono in dollari. Per convertirli uso un cambio di circa 1,14 dollari per euro, il livello attorno a cui l’euro si muoveva nei primi giorni di luglio 2026 secondo i tassi di riferimento della BCE. Il cambio si muove: gli importi in euro qui sotto sono indicativi, quelli in dollari sono i prezzi contrattuali.
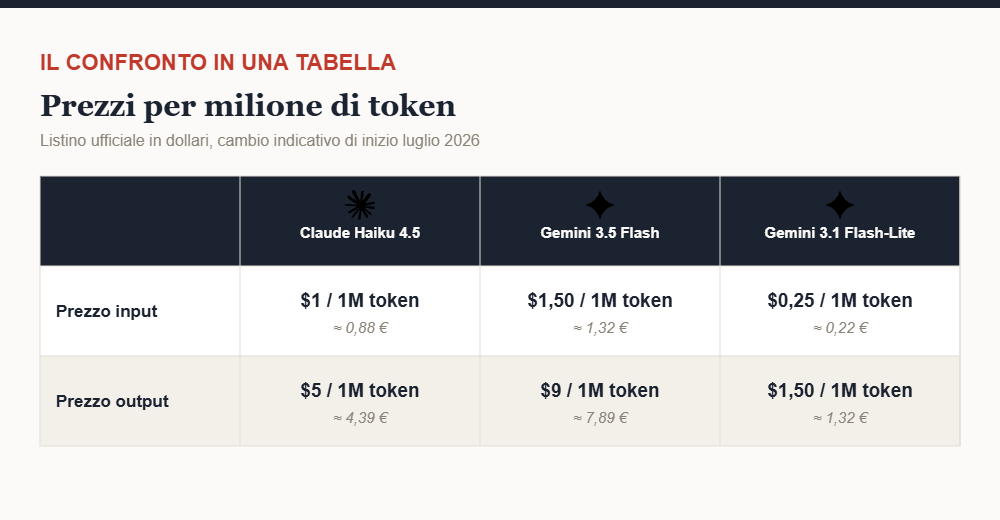
Dalla pagina prezzi ufficiale di Anthropic, Claude Haiku 4.5 costa 1 dollaro per milione di token in input e 5 dollari in output. In euro: circa 0,88 € in input e 4,39 € in output.
Dalla pagina prezzi ufficiale dell’API Gemini, la famiglia Flash ha due gradini. Gemini 3.5 Flash costa 1,50 dollari in input e 9 dollari in output, cioè circa 1,32 € e 7,89 €. Gemini 3.1 Flash-Lite, il gradino sotto, costa 0,25 dollari in input e 1,50 in output: circa 0,22 € e 1,32 €.
Per avere il senso delle proporzioni, sempre da listino: Claude Opus 4.8 sta a 5 e 25 dollari (circa 4,39 € e 21,93 €), Claude Fable 5 a 10 e 50 dollari (circa 8,77 € e 43,86 €), Gemini 3.1 Pro a 2 e 12 dollari per i prompt sotto i 200.000 token (circa 1,75 € e 10,53 €).
Quindi il titolo non è un’esagerazione: rispetto al modello più caro del listino Anthropic, Haiku costa esattamente un decimo. Rispetto a Opus, un quinto.
C’è un dettaglio tecnico che sfugge quasi sempre e che sposta i conti. Anthropic scrive nella stessa pagina che i modelli più recenti (Opus 4.7 e successivi, Sonnet 5, Fable 5) usano un tokenizzatore nuovo che produce circa il 30% di token in più a parità di testo. Haiku 4.5 usa quello vecchio. Vuol dire che il divario di costo reale tra Haiku e i modelli di punta è ancora più ampio di quanto suggerisca il rapporto tra i prezzi.
Il conto vero di un’app che gira su un modello piccolo
Facciamo un esempio concreto, e lo dichiaro subito come caso ipotetico: non è un cliente reale, è un conto che puoi rifare con i tuoi numeri.
Un e-commerce italiano di medie dimensioni riceve 30.000 messaggi al mese tra email e form di contatto. Vuole un sistema che legga ogni messaggio, capisca di cosa parla (spedizione, reso, fattura, reclamo, richiesta commerciale), estragga il numero d’ordine se c’è e assegni il messaggio alla persona giusta. Nient’altro: non scrive risposte, non parla con il cliente.
Stimiamo 800 token di input per messaggio (istruzioni più testo dell’email) e 150 token di output (una risposta strutturata breve, tipo categoria, urgenza, numero d’ordine). Fanno 24 milioni di token in input e 4,5 milioni in output al mese.
| Modello | Costo mensile stimato |
|---|---|
| Gemini 3.1 Flash-Lite | ~11 € |
| Claude Haiku 4.5 | ~41 € |
| Gemini 3.5 Flash | ~67 € |
| Claude Opus 4.8 | ~204 € |
| Claude Fable 5 | ~408 € |
Il conto per Haiku: 24 × 0,88 € = 21,05 € di input, più 4,5 × 4,39 € = 19,74 € di output. Totale 40,79 €. Gli altri si calcolano allo stesso modo con i prezzi sopra.
Guarda la differenza tra la prima e l’ultima riga: 11 € contro 408 €. Per un lavoro di classificazione, cioè la cosa più semplice che si possa chiedere a un modello linguistico. È qui che si bruciano i budget: non su un uso sbagliato dell’AI, ma su un modello sovradimensionato lasciato lì per pigrizia.
Come tagliare ancora: batch e cache
Due meccanismi valgono la pena di essere conosciuti perché si applicano a entrambi i fornitori.
Il batch (elaborazione asincrona: mandi mille richieste e ti riprendi i risultati dopo, senza risposta immediata) costa metà. Anthropic dichiara Haiku 4.5 in batch a 0,50 e 2,50 dollari, circa 0,44 € e 2,19 € (listino Anthropic). Google dichiara Gemini 3.5 Flash in batch a 0,75 e 4,50 dollari, circa 0,66 € e 3,95 € (listino Gemini). Se il tuo caso d’uso tollera un’attesa di qualche ora — smistare la posta della notte, riassumere i log del giorno prima — hai già dimezzato la bolletta senza cambiare una riga di codice.
Il prompt caching (la parte fissa del prompt viene memorizzata e non riprocessata a ogni chiamata) è ancora più interessante quando le istruzioni sono lunghe. Anthropic fa pagare la lettura dalla cache il 10% del prezzo base: per Haiku sono 0,10 dollari, circa 0,09 € per milione di token. Se le tue 800 token di input sono per 600 sempre le stesse istruzioni, quella parte quasi sparisce dal conto.
Dove il modello piccolo basta e basta bene
Ci sono quattro famiglie di compiti dove, stando a come i due fornitori stessi posizionano questi modelli nella loro documentazione, il modello piccolo non ha praticamente svantaggi.
La classificazione: assegnare un’etichetta a un testo scegliendo da una lista chiusa. Categorie di ticket, sentiment, lingua, priorità. Il compito è vincolato, le opzioni sono poche, un modello grande non ha spazio per essere più bravo.
L’estrazione strutturata: tirare fuori da un documento dei campi precisi (partita IVA, importo, data, IBAN) e restituirli in un formato fisso. Qui conta la costanza, non il ragionamento.
Il riassunto di testi corti e medi: verbali, thread di email, trascrizioni di call. I modelli piccoli riassumono in modo perfettamente leggibile.
Il routing: decidere cosa fare dopo. Questa domanda va all’assistenza o al commerciale? Serve una ricerca sul database o basta rispondere? Il modello piccolo fa da smistatore veloce ed economico, e solo quando serve chiama il modello grande. È l’architettura che Anthropic stessa suggerisce quando descrive Sonnet che scompone un problema e orchestra più istanze di Haiku in parallelo — cioè, in sostanza, un agente che decide un passo alla volta e delega quelli banali a chi costa meno.
Dove il modello piccolo non basta
Sono altrettanto netto sul contrario, perché il modello piccolo viene venduto come panacea e non lo è.
Non regge sui compiti a molti passaggi in cui un errore all’inizio avvelena tutto il resto: un agente che deve leggere sei documenti, incrociarli, dedurre una conclusione e poi agire. Non regge sui ragionamenti giuridici, fiscali o medici in cui una sfumatura cambia la risposta — ed è il motivo per cui, quando l’output finisce davanti a un giudice o a un cliente, va verificato riga per riga da una persona che ci mette la firma, qualunque modello tu abbia scelto. Non regge quando il testo di partenza è ambiguo, mal scritto o contraddittorio e serve capire cosa voleva dire davvero chi ha scritto. E non regge sulla scrittura che deve avere una voce: un modello piccolo scrive corretto e piatto.
C’è poi una zona grigia importante: il codice. I modelli piccoli oggi programmano bene, ma “bene” su problemi circoscritti. Su una base di codice grande, con dipendenze e vincoli impliciti, il divario con i modelli di punta si vede ancora.

L’opinione: smettila di scegliere il modello, scegli l’architettura
La domanda “Haiku o Flash?” è quasi sempre la domanda sbagliata, e qui prendo posizione. La differenza tra i due, per la maggior parte dei compiti semplici, è marginale rispetto a quello che ti fa risparmiare davvero: usare più modelli nella stessa applicazione.
Il pattern che funziona è a due stadi. Un modello piccolo, o addirittura piccolissimo come Flash-Lite, fa il primo passaggio su tutto il volume: filtra, classifica, scarta il rumore. Solo la frazione di casi che quel primo passaggio segnala come complessi o incerti sale al modello grande. Il risparmio dipende da quanto traffico banale hai: rifai il conto sui tuoi volumi con i prezzi qui sopra, ed è quasi sempre la leva più grossa che hai a disposizione.
Detto questo, se proprio devi scegliere uno solo: Flash-Lite quando il compito è meccanico e il volume è alto, perché il prezzo è imbattibile. Haiku 4.5 quando il compito ha un minimo di giudizio dentro e ti serve che sbagli poco, perché la fascia di prezzo è ancora bassa ma la qualità è di un altro gradino. Gemini 3.5 Flash quando ti serve la finestra di contesto molto ampia o l’integrazione con la ricerca Google, che sul listino Gemini è indicata con 5.000 richieste al mese incluse (quota condivisa tra i modelli Gemini 3) e poi 14 dollari ogni 1.000 ricerche.
E fai una prova tua su cinquanta casi reali presi dai tuoi dati, prima di decidere. I benchmark pubblicati dai fornitori dicono qualcosa sul modello, non dicono niente sul tuo problema.
Cosa cambia per te
Se hai un’applicazione in produzione che gira su un modello di fascia alta, apri la fattura del mese scorso e guarda quanti token consumi e per fare cosa. Se il grosso del