Anthropic ha lanciato Claude Sonnet 5.5 il 28 settembre 2026, sei giorni dopo l’arrivo di GPT-6 Astra di OpenAI. I due modelli non nascono per lo stesso pubblico: Astra punta al lavoro pesante e costa di più, Sonnet 5.5 si propone come il modello di tutti i giorni a parità di prezzo con il predecessore. Ma la stessa settimana Artificial Analysis li ha misurati sullo stesso banco di prova, il suo Intelligence Index, e il risultato racconta una storia più complicata di quella riassunta negli annunci ufficiali: chi vince dipende da cosa si sta cercando, il punteggio più alto o il conto più basso a fine mese.
Il punteggio Artificial Analysis: Sonnet 5.5 secondo, Astra terzo
Il 28 settembre, poche ore dopo il lancio di Claude Sonnet 5.5, Artificial Analysis ha pubblicato la prima misurazione indipendente del modello. Sull’Intelligence Index il modello ottiene 56 punti, un salto di 18 punti rispetto ai 38 di Sonnet 5: il miglioramento generazionale più netto misurato quest’anno dal laboratorio su un modello di fascia Sonnet. È il secondo punteggio più alto mai registrato, staccato di soli 2 punti da Claude Opus 5.5 (58) e davanti sia a GPT-6 Astra di OpenAI sia a Claude Fable 5.1, entrambi fermi a 53 punti.
Per capire la portata del salto conviene guardarlo così: la versione di fascia intermedia della famiglia Claude oggi supera, su questo specifico indice aggregato di benchmark, il modello più caro e più recente che OpenAI abbia mai messo sul mercato. Non è un dettaglio da poco per chi sceglie un modello guardando principalmente ai punteggi pubblicati dai laboratori indipendenti, invece che ai soli comunicati delle aziende produttrici.
Nel confronto rientra anche Claude Fable 5.1, il modello di Anthropic più orientato alla scrittura creativa e alla conversazione, fermo anch’esso a 53 punti come GPT-6 Astra. Il dato conferma quanto la famiglia Claude, nel giro di poche settimane, abbia stretto il divario che la separava dai modelli di punta della concorrenza su più fasce contemporaneamente, non solo su quella intermedia occupata da Sonnet.
Il paradosso dei token: chi consuma di più per lo stesso risultato
Il punteggio, però, non racconta tutta la storia. Impostato al massimo livello di sforzo di ragionamento, Sonnet 5.5 genera in media circa 193.000 token di output per ogni compito dell’Intelligence Index. È il consumo più alto mai misurato da Artificial Analysis su un modello di produzione: il 60% in più di Claude Opus 5.5 e della stessa Sonnet 5, che si fermano entrambi intorno ai 120.625 token, e quasi sette volte il consumo di GPT-6 Astra, che nello stesso scenario resta a circa 27.571 token.
Tradotto in pratica: per arrivare al punteggio di 56, Sonnet 5.5 ragiona molto più a lungo del necessario. Astra, con un punteggio inferiore di soli 3 punti, ci arriva generando una frazione dei token. È un esito opposto rispetto a quanto raccontato nell’annuncio ufficiale di Anthropic, dove si parla di un modello che genera risposte oltre il 30% più velocemente del predecessore e che, nei casi d’uso reali, riduce i costi fino al 30% per attività: l’esempio citato riguarda il gestore patrimoniale Balyasny Asset Management, che avrebbe misurato circa 121.000 token per risposta nel proprio flusso di lavoro. Le due cifre non si contraddicono, descrivono semplicemente scenari diversi. Con lo sforzo di ragionamento impostato al minimo indispensabile, Sonnet 5.5 può davvero costare meno di Sonnet 5 a parità di attività. Spinto al massimo sforzo, come nel test di Artificial Analysis, il conto cambia radicalmente: un singolo task in quella configurazione arriva a costare circa 6,70 euro, circa il 50% in più di Sonnet 5, nonostante il prezzo per token sia rimasto identico.
Prezzo per milione di token, in euro
Il listino di entrambi i modelli è pubblicato in dollari; la tabella qui sotto converte le cifre in euro al cambio di fine settembre 2026, circa 0,88 euro per dollaro.
| Modello | Input per milione di token | Output per milione di token | Data di lancio |
|---|---|---|---|
| Claude Sonnet 5.5 | 2$ (circa 1,76€) | 10$ (circa 8,80€) | 28 settembre 2026 |
| Claude Opus 5.5 | 4$ (circa 3,52€) | 20$ (circa 17,60€) | 22 settembre 2026 |
| GPT-6 Astra | 10$ (circa 8,80€) | 50$ (circa 44€) | 22 settembre 2026 |
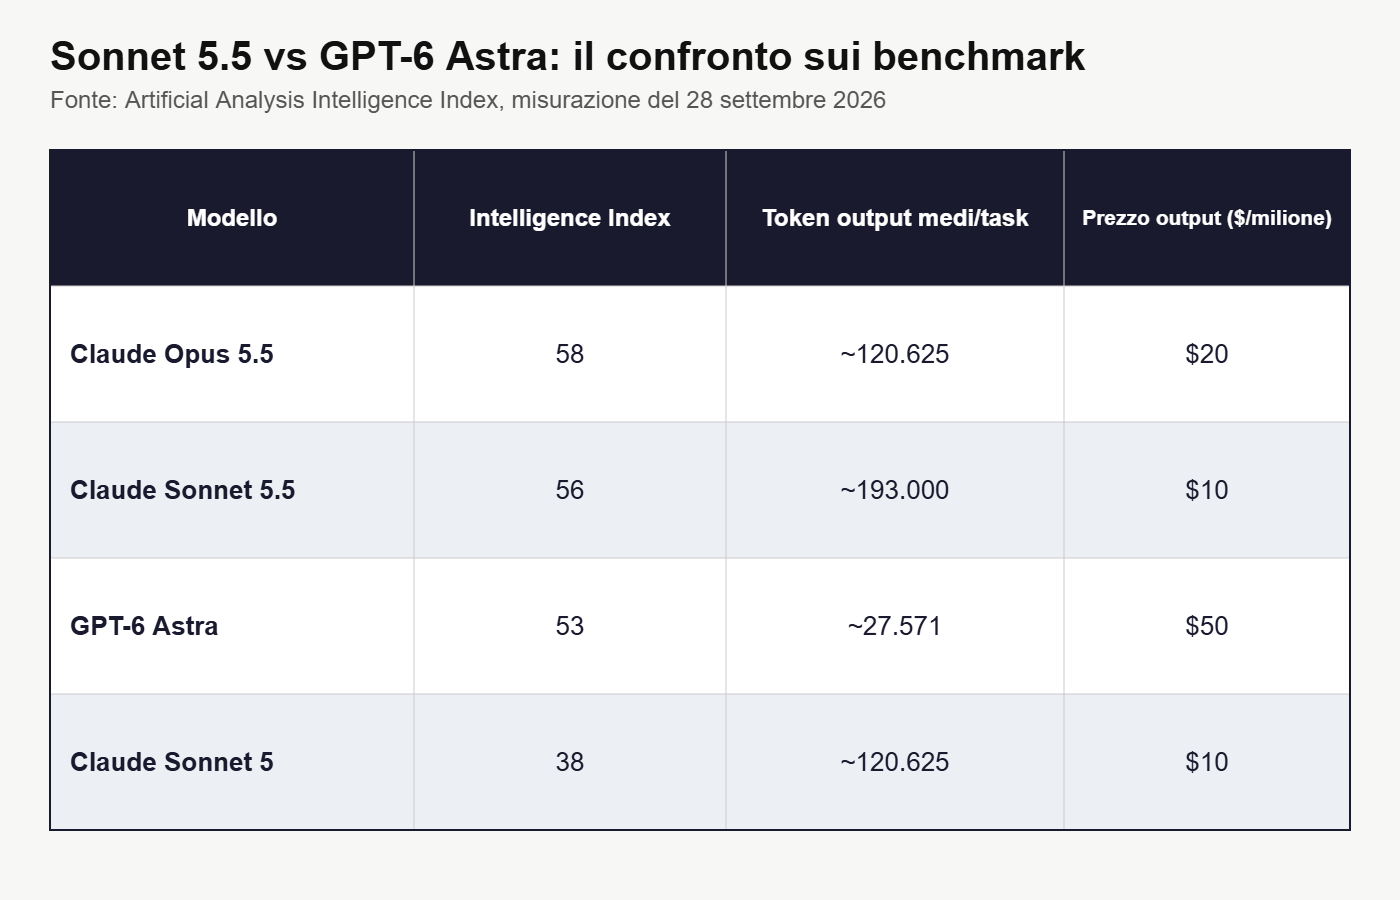
Guardando solo il prezzo per token, Astra costa cinque volte più di Sonnet 5.5 sull’output. Ma il conto per singolo task racconta un’altra parte della storia: considerando i circa 27.571 token medi rilevati da Artificial Analysis per Astra, contro i 193.000 di Sonnet 5.5 nello stesso scenario, il numero di token generati pesa quanto e più del prezzo per token nel determinare la spesa finale. Artificial Analysis non ha pubblicato una cifra equivalente in euro per il task di Astra, ma un consumo quasi sette volte inferiore lascia intuire un conto finale nell’ordine di pochi euro, anche a un prezzo per token cinque volte più alto.
Dove si usano oggi i due modelli
Claude Sonnet 5.5 è già disponibile su tutte le piattaforme Anthropic: app Claude, Claude Code, Claude.ai per le versioni a pagamento e l’API per gli sviluppatori, con lo stesso schema di prezzi di Sonnet 5. Anthropic ha fatto seguire il lancio, a distanza di pochi giorni, dall’apertura di uno store di plugin per sviluppatori pensato per ampliare l’ecosistema attorno ai propri modelli, segno che la strategia punta sull’adozione diffusa più che su un singolo salto prestazionale.
GPT-6 Astra, invece, procede a scaglioni: è già attivo su ChatGPT Plus, Pro, Business ed Enterprise, oltre che nell’API di OpenAI, in Codex e su Microsoft Azure e AWS Bedrock, ma non è incluso nei piani gratuiti né in ChatGPT Go, e il rollout sui piani a pagamento non raggiunge tutti gli utenti nello stesso momento del lancio. Chi valuta oggi quale modello adottare deve tenere conto anche di questa differenza pratica: Sonnet 5.5 è immediatamente disponibile ovunque si usi già Claude, Astra richiede in alcuni casi ancora qualche giorno di attesa.
Cosa cambia rispetto ai modelli precedenti
Sonnet 5.5 non è un salto generazionale: Anthropic lo presenta come un aggiornamento diretto di Sonnet 5, pensato per sostituirlo nell’uso quotidiano, non per competere con la fascia più costosa della propria gamma. Il prezzo resta identico a quello del predecessore, l’azienda promette risposte oltre il 30% più veloci e, nei casi reali misurati sui clienti enterprise, un risparmio dichiarato fino al 30% sul costo per attività. Restano fuori dal confronto i compiti complessi e aperti, dove la stessa Anthropic ammette che Opus 5.5 «resta nettamente più forte».
GPT-6 Astra segue una logica simile ma capovolta. OpenAI lo ha lanciato il 22 settembre come punta di diamante della gamma, senza sostituire GPT-6 Sol e Luna, le due versioni economiche arrivate nelle settimane precedenti e già messe a confronto su queste pagine con Claude Opus 5.5 sui prezzi. Astra punta su ragionamento esteso, controllo del computer e compiti lunghi: è il modello più caro della famiglia GPT-6, non quello pensato per i volumi alti.
Dove Astra resta avanti
L’Intelligence Index misura ragionamento e conoscenza generale, non tutto quello che conta nel lavoro reale. Sul controllo del computer, GPT-6 Astra resta il modello OpenAI più veloce mai testato: 72,6% su OSWorld 2.0 in circa 40 minuti, contro il 65,7% in 75 minuti della generazione precedente. Sulla sicurezza, nei test interni di OpenAI il modello non ha registrato deviazioni non autorizzate, mentre la versione precedente ne aveva il 48% senza protezioni attive. La finestra di contesto supera il milione di token via API, utile su basi di codice e documenti lunghi: un’area dove Anthropic non ha ancora comunicato numeri comparabili per Sonnet 5.5.
Sono terreni dove il punteggio aggregato dell’Intelligence Index conta relativamente poco, e dove chi automatizza flussi di lavoro o gestisce dati sensibili guarda a criteri diversi dal solo posizionamento in classifica.
Per chi conviene l’uno o per chi l’altro
Chi genera molto testo o codice su base quotidiana, con un budget di token sotto controllo e uno sforzo di ragionamento impostato con criterio, trova in Sonnet 5.5 un aggiornamento reale a parità di spesa: più intelligenza, stesso prezzo per token, a patto di non lasciare sempre l’impostazione al massimo livello. Un team che già lavora con Sonnet 5 può passare al nuovo modello senza rivedere il budget, ma dovrebbe monitorare per le prime settimane il consumo effettivo di token sui propri flussi di lavoro, proprio per evitare l’effetto osservato da Artificial Analysis in configurazione di massimo sforzo.
Chi lavora su compiti lunghi e strutturati, o ha bisogno di controllo del computer e finestre di contesto ampie, resta meglio servito da GPT-6 Astra, pagando un prezzo per token più alto ma partendo da un consumo di token molto più contenuto e da capacità, come il controllo del computer testato su OSWorld 2.0, che l’Intelligence Index non misura. Per chi cerca il punteggio più alto in assoluto, senza vincoli di budget, resta davanti a entrambi Claude Opus 5.5, sia pure con un margine ormai sottile rispetto al modello di fascia inferiore della stessa famiglia.
Il quadro che emerge da questa prima misurazione indipendente conferma un pattern già visto con altri lanci del 2026: i numeri comunicati dai produttori descrivono lo scenario più favorevole, non quello medio. Un punteggio più alto non garantisce un conto più basso, e un modello con un prezzo per token inferiore non è automaticamente il più economico in assoluto una volta contati i token effettivamente generati. Le prossime settimane, con nuovi benchmark indipendenti e i primi resoconti di consumo reale da parte delle aziende che hanno già integrato Sonnet 5.5, diranno se il compromesso trovato da Anthropic regge anche fuori dai casi citati negli annunci ufficiali.